


In der Technologiebranche kann man kaum ein Gespräch führen, ohne dass jemand Schlussfolgerungen, künstliche Intelligenz (KI) und maschinelles Lernen (ML) erwähnt. Es ist jedoch wichtig zu beachten, dass alle diese Begriffe zwar miteinander verbunden sind, sich aber auch erheblich unterscheiden.
In diesem Artikel erläutern wir die grundlegenden Unterschiede und betonen die Bedeutung des Einsatzes der auf Tensorverarbeitung-basierten Edge-KI-Technologie, insbesondere in Edge- und eingebetteten Systemen. Im Vergleich zu Lösungen, die auf Grafikprozessoren (GPUs) basieren, bieten Tensorprozessoren (TPUs) eine effizientere und kostengünstigere Leistung. Wir stellen außerdem einige Anwendungsbeispiele vor, die veranschaulichen, wo Sie in Zukunft auf Edge-KI-Lösungen stoßen könnten.
Grundlagen von ML und Inferenz
ML bezieht sich auf die Methodik, Modelle mithilfe repräsentativer Daten zu trainieren, damit Maschinen lernen können, wie Aufgaben ausgeführt werden. Dieser Prozess kann sehr rechenintensiv sein und Billionen von Operationen pro neuem Trainingsdatenpunkt generieren. Der iterative Charakter des Trainingsprozesses in Kombination mit den enormen Trainingsdatensätzen, die zum Erreichen einer hohen Genauigkeit erforderlich sind, treibt die Nachfrage nach einer Gleitkommaverarbeitung mit extrem hoher -Leistung- voran. ML-Schulungen lassen sich am besten als Rechenzentrumsinfrastruktur implementieren, wo hohe Kapital- und Betriebskosten durch die Amortisierung auf zahlreiche Kunden gerechtfertigt werden können.
Bei der Inferenz werden trainierte Modelle verwendet, um potenzielle Übereinstimmungen für neue Daten zu generieren, die für die repräsentativen Daten relevant sind, auf denen das Modell trainiert wurde. Inference zielt darauf ab, schnelle Antworten innerhalb von Millisekunden zu liefern. Beispiele für Schlussfolgerungen sind Spracherkennung, Sprachübersetzung in Echtzeit-, maschinelles Sehen und Entscheidungen zur Optimierung von Werbeeinfügungen. Während die Inferenz nur einen Bruchteil der für das Training erforderlichen Rechenleistung erfordert, übersteigt sie dennoch bei weitem das, was herkömmliche Systeme auf Basis einer Zentraleinheit (CPU)- liefern können, insbesondere für Computer-Vision-Anwendungen. Aus diesem Grund greifen so viele Unternehmen auf Tensor-{6}basierte Beschleunigungslösungen-ob als IP auf SoCs oder als -Systembeschleuniger-zu, um die am Edge erforderlichen Reaktionszeiten von weniger als{10}}Sekunden zu erreichen. Die Realität ist, dass es nicht sehr sinnvoll ist, auch nur eine Minute oder ein paar Sekunden mit der Verarbeitung von Bildern in einem Bildverarbeitungssystem zu verbringen. Industrielle Bildverarbeitungssysteme streben nach Verarbeitungsgeschwindigkeiten im Millisekundenbereich-.
Trennung von Training und Schlussfolgerung
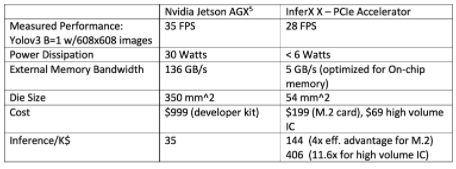
Die Bereitstellung derselben Hardware, die für das Training verwendet wird, um Inferenzarbeitslasten zu verarbeiten, kann zu einer Über{0}}Bereitstellung von Inferenzmaschinen mit Beschleunigern und CPU-Hardware führen. GPU-Lösungen, die im letzten Jahrzehnt für ML entwickelt wurden, sind nicht unbedingt die optimale Wahl für den groß angelegten Einsatz von ML-Inferenztechnologien. Das folgende Diagramm veranschaulicht perfekt den Vergleich zwischen TPU-Beschleunigern und GPU-Beschleunigern. Es zeigt deutlich, dass TPU-Beschleuniger im Vergleich zu GPU--basierten AGX-Lösungen einen geringeren Stromverbrauch, geringere Kosten und eine höhere Effizienz bieten und dennoch überzeugende Leistungsniveaus für Inferenzanwendungen bieten.
Ein weiterer wichtiger Aspekt bei der Herangehensweise an ML-Trainings- und Inferenzlösungen ist die Softwareumgebung. Heutzutage werden zahlreiche beliebte Bibliotheken verwendet, etwa CUDA für NVIDIA-GPUs, ML-Frameworks wie TensorFlow und PyTorch, optimierte plattformübergreifende Modellbibliotheken wie Keras und mehr. Diese Toolkits sind für die Entwicklung und das Training von ML-Modellen unerlässlich, aber Inferenzanwendungen erfordern einen anderen, kleineren Satz an Softwaretools.
Inferenz-Toolkits konzentrieren sich auf die Ausführung von Modellen auf Zielplattformen. Sie unterstützen die Portierung trainierter Modelle auf Plattformen, was einige Operatortransformationen, Quantisierung und Host-Integrationsdienste umfassen kann. Im Vergleich zu denen, die für die Modellentwicklung und -schulung erforderlich sind, stellt dies jedoch einen relativ einfachen Satz an Funktionalitäten dar.
Inferenzwerkzeuge profitieren davon, mit einer standardisierten Darstellung des Modells zu beginnen. Der Open Neural Network Exchange (ONNX) ist das Standardformat zur Darstellung von ML-Modellen. Wie der Name schon sagt, handelt es sich um einen offenen Standard, der als Linux Foundation-Projekt verwaltet wird. Technologien wie ONNX ermöglichen die Entkopplung von Trainings- und Inferenzsystemen und geben Entwicklern die Freiheit, jeweils unterschiedliche optimierte Plattformen auszuwählen.
Beispielhafte visuelle Anwendungen
Da ML- und Inferenzprozessortechnologien immer weiter voranschreiten und sich weiterentwickeln, nehmen die Anwendungen zu. Im Folgenden sind nur einige Orte aufgeführt, an denen Sie in Zukunft auf diese Technologie stoßen könnten.
Edge-Server in Unternehmen wie Fabriken, Krankenhäusern, Einzelhandelsgeschäften und Finanzinstituten. In industriellen Umgebungen kann KI beispielsweise bei der Bestandsverwaltung, der Fehlererkennung und sogar der vorausschauenden Wartung helfen, bevor Probleme auftreten. Im Einzelhandel ermöglicht es Funktionen wie die Posenschätzung, bei der mithilfe von Computer Vision die menschliche Haltung erkannt und analysiert wird. Die Daten aus dieser Analyse helfen stationären Einzelhändlern, das menschliche Verhalten und den Fußgängerverkehr in ihren Geschäften besser zu verstehen, sodass sie die Ladengestaltung für maximale Verkäufe und Kundenzufriedenheit optimieren können.
Hoch-präzise/hochwertige-Bildgebung für Anwendungen wie Robotik, industrielle Automatisierung/Inspektion, medizinische Bildgebung, wissenschaftliche Bildgebung, Überwachungs- und Objekterkennungskameras sowie Photonik. Beispielsweise haben Methoden des maschinellen Lernens die Fähigkeit gezeigt, Krebs durch die Verarbeitung digitaler Röntgenstrahlen zu erkennen. Dieser Prozess beinhaltet die Entwicklung eines ML-Modells zur Verarbeitung von Röntgenbildern, wobei typischerweise trainierte semantische Segmentierungsalgorithmen verwendet werden, um Krebsläsionen zu identifizieren. Während des Trainings werden von Radiologen identifizierte Krebsbilder verwendet, um dem Netzwerk zu vermitteln, was kein Krebs ist, was Krebs ist und wie verschiedene Krebsarten aussehen. Je mehr ein ML-Modell trainiert wird, desto besser gelingt es ihm, korrekte Diagnosen zu maximieren und Fehldiagnosen zu minimieren. Das bedeutet, dass maschinelles Lernen nicht nur auf intelligentem Modelldesign beruht, sondern auch auf riesigen Mengen (Zehntausende bis Millionen) sorgfältig kuratierter Datenbeispiele, bei denen Krebs fachmännisch identifiziert wurde.
Intelligente Einkaufswagen{0}}Mehrere Unternehmen entwickeln und implementieren intelligente Einkaufssysteme, die Produkte nicht anhand ihrer UPC-Barcodes, sondern anhand des visuellen Erscheinungsbilds der Verpackung selbst erkennen. Mit dieser Funktion können Käufer Artikel einfach in den Warenkorb oder auf das Kassensystem legen, ohne den UPC-Code suchen und mit einem UPC-Laserscanner scannen zu müssen. Diese Technologie macht den Einkaufsvorgang präziser, schneller und bequemer.
Die richtige Entscheidung treffen
Unternehmen müssen heute alle verfügbaren Lösungen bewerten und basierend auf ihrem spezifischen Anwendungsfall die optimale auswählen. Sie können auch nicht einfach davon ausgehen, dass alle KI-Lösungen am besten auf GPU-Geräten implementiert werden, da TPU-basierte Lösungen eine höhere Verarbeitungseffizienz und eine geringere Siliziumauslastung bieten und dadurch den Stromverbrauch und die Kosten senken.