


Audio ist ein wesentlicher Bestandteil vieler IoT -Anwendungen, einschließlich Konsumgüterprodukten wie Lautsprechern und Kopfhörern, Wearables und Medizinprodukten (z. B. Hörgeräten), Automatisierung und industriellen Kontrollanwendungen, Unterhaltungssystemen und Automobil -Infotainment -Einheiten.
IoT-Audio kann weitgehend in drei Typen eingeteilt werden: Streaming (z. Das Entwerfen hochwertiger, ununterbrochener akustischer Audio-Subsysteme kann jedoch schwierig sein, wenn Ingenieure die für IoT-basierten Geräte erforderlichen strengen Einschränkungen einhalten müssen.
Komplexere Entwürfe sind erforderlich, um erweiterte Funktionen wie die Spracherkennung zu enthalten, z. B. die Ermöglichung von Fahrern, das Infotainment-System in ihrem Auto auf die gleiche Weise wie ein Handy zu steuern. Da die MCU im Mittelpunkt all dieser Audiosysteme steht, ist es wichtig, eine MCU auszuwählen, die die erforderlichen Audio-Technologien integriert, die für die Entwurf eines zuverlässigen rauschfreien Audiosystems erforderlich sind. In diesem Artikel werden die Audio -Technologien untersucht, mit denen solche Systeme gestaltet werden können.
Komponenten eines Audio -Subsystems
IoT-Audio beinhaltet drei Hauptaktivitäten: Dampf-Sprach/Daten, drahtlose Übertragung und Sprachreorganisationskontrolle. Abbildung 1 zeigt die wichtigsten Bausteine in einem eingebetteten System.
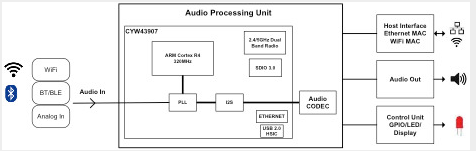
Dieses Blockdiagramm zeigt die wichtigeren Bausteine des Audio -Verarbeitungs -Subsystems
Beachten Sie, dass viele dieser Funktionen in moderne MCUs integriert werden können, wie z.
Musikanwendungen
Mit Audio-fähiger MCUs können Ingenieure MP3/4-Streams dekodieren, die von den meisten beliebten Medienspieler und Content-Anbietern verwendet werden. Viele Designs müssen auch die AAC -Dekodierung von WMA und Apple unterstützen, was zusätzliche Verarbeitungsleistung erfordert. In Verbraucher-Audioanwendungen kann ein kostengünstiges Audio-MCUs häufig verwendet werden, indem digitale Musikstreams aus Audiozubehör wie digitaler Sprecher-Sets verwaltet werden.
In diesen Anwendungen kommt ein Bild von PCM -Audiodaten (in einem USB -Audioklasse -Format eingekapselt) alle 1 ms über einen der seriellen SPI/I²C -Kanäle des Prozessors an. Abhängig von der Quelle kann der Audiostrom in einem von mehreren Formaten (dh links ausgerichtet, rechts ausgerichtet, i2s usw.) eintreffen. Einige kostengünstige Codecs können jedoch nur bestimmte Formate akzeptieren. In diesen Fällen spielt die MCU eine wichtige Rolle, um sicherzustellen, dass die Daten korrekt ausgerichtet sind, bevor sie dem Codec zugeführt werden.
Da nicht alle Audioquellen die gleiche Stichprobenrate verwenden, muss der Codec auch ihre Abtastfrequenz an die Quelle anpassen oder sich auf die MCU verlassen, um den Stichprobendatenstrom in eine gemeinsame Datenrate umzuwandeln (siehe Abbildung 2). In diesen Fällen muss die MCU den Stream verwalten, um Unter- oder Überlastbedingungen zu vermeiden, die zu Stummschalten, POPs und Audio-Diskontinuitäten führen können, die Datenverlust verursachen und das Hörerlebnis des Benutzers stören können. Beachten Sie, dass die Audio -MCU auch zur Implementierung anderer Funktionen des Audio -Subsystems verwendet werden kann, z. B. die Kontrolle der Beleuchtung während der Audio -Wiedergabe.
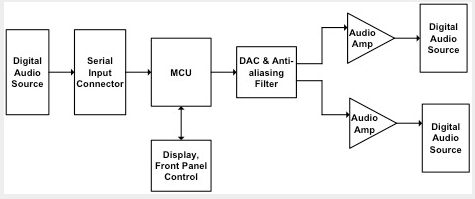
Die Audio -MCU muss möglicherweise eine Formatkonvertierung, die Anpassung der Stichprobenrate und die Stream -Verwaltung sowie die Audio -Benutzeroberflächen unterstützen.
Um Audio in einer Vielzahl von Anwendungen zu implementieren, muss Audio MCUs eine Vielzahl von Audio -Technologien unterstützen. Abbildung 3 zeigt Beispiele für diese Audio -Technologien.
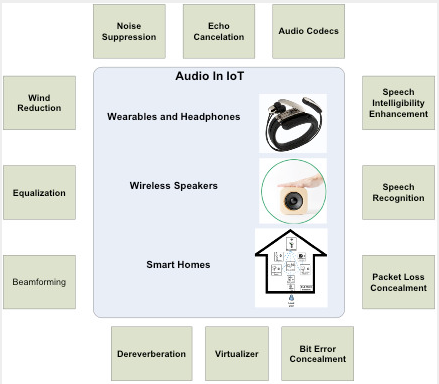
Tontechnologie
Audio -Codecs
Audio-Codecs sind die Hauptkomponente eines Audiosystems. Viele MCUs, die für IoT -Anwendungen erstellt wurden, unterstützen die Codec -Funktionen in Hardware. Auf diese Weise kann das System die Größe digitaler Audio -Proben reduzieren, um die drahtlose Getriebe (Strom sparen) und den Speicherplatz zu sparen (Reduzierung der Dehnung der internen Speicherkapazität). Der Codec kann verschiedene Audio -Standardformate wie AAC, AC -3 und Alac unterstützen. Dazu sind eine Decoding Access Unit (AU) erforderlich, die vor einer Audio-Nachbearbeitung (z. B. DSOLA, SOLA) implementiert wird. Bei Verwendung mit Standard -Audioformaten wie AAC, AC -3 und ALAC wird Audio so kategorisiert, dass nachfolgende Audioproben innerhalb des im Audio -Paket -Datenstroms angegebenen vorgeschriebenen Formats liegen. Der Paketabstand wird auch gelungen, um minimaler Quer Jitter und ununterbrochener Betrieb in Anwesenheit von Staus zu ermöglichen. Die AU -Nutzlastgröße ermöglicht die Ausführung jeglicher Verschleierung, die durchgeführt werden muss.
Basisbandverarbeitung
Ein Basisbandsignal ist die grundlegende Gruppe von Frequenzen in einer analogen oder digitalen Wellenform, die durch elektronische Schaltungen verarbeitet werden kann. Ein Basisbandsignal kann aus einer einzelnen Frequenz oder einer Gruppe von Frequenzen oder in der digitalen Domäne bestehen, die über einen nicht-multiplexierten Kanal gesendet werden. Basisband ist definiert als das mit dem Trägersignal gemischte Basisband (Signal/Sekunde), um ein moduliertes Signal zu erzeugen. Beachten Sie, dass der Audio -Codec in MCUs, der IoT -Audio unterstützt, die Basisbandverarbeitung und RF in einem einzigen Chip integriert. Der Audio -Codec kann in einer Vielzahl von drahtlosen Transceivern implementiert werden, um Sprachdaten und/oder Musikfunktionen bereitzustellen. Der Codec verfügt außerdem über Mono- und Stereo -Kanäle für die Audioausgabe sowie Stereoeingänge.
Verschleierung von Paketverlust und Datenreplikation
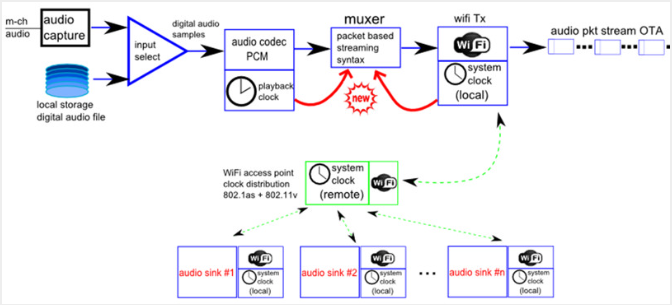
Übermäßige Latenz, Paketverlust und Jitter mit hoher Latenz können die Qualität der Kommunikation beeinträchtigen. Die Wahrscheinlichkeit eines plötzlichen Paketverlusts nimmt mit der Netzwerkbelastung zu und führt zu Unterbrechungen, die vom Benutzer zu hören sind. Eine robuste Audioübertragung über WLAN kann durch fortschrittliche Funktionen wie die Verschleierung von Paketverlusten von Cypress-Paketverlust verbessert werden. Die Quelle/den Empfänger der Systemarchitektur lautet wie folgt: Eine Quelle erfasst das Audio, multiplexiert die PCM -Daten über die RTP -Stream -Struktur und synchronisiert die Uhr mit allen an die SPS -Quelle verbundenen Empfänger.
Beachten Sie, dass die Leistung des Kommunikationsverbaus von der Qualität der Link -Budget -Leistung abhängt. Dieses Verbindungsbudget wird durch drei Faktoren bestimmt: Stromübertragung, Übertragungsantennengewinn und Antennengewinn erhalten. Beispielsweise ist eine zuverlässige Kommunikation über ein 802.11 -Netzwerk möglich, wenn die Leistung des Linkpfads abzüglich des Verlusts des verfügbaren Raums größer ist als die minimal empfangene Signalstufe des empfangenden Radios (siehe Abbildung 4).
Die Leistung eines Kommunikationsverbaus hängt von der Qualität der Link -Budget -Leistung ab
Verbesserung der Sprachverständlichkeit (SIE)
Hintergrundgeräusche im Audiosystem können die Verständlichkeit der Sprache verringern. Wenn das Rauschen einen bestimmten Level überschreitet, kann die Rede für den Benutzer schwierig sein, es zu verstehen. Die Verfügbarkeit von Echtzeit-kontinuierlicher Spracherkennung auf eingebetteten Geräten erfordert ein System, das die Verständlichkeit von Geräuschreden verbessert. Die Auswahl einer MCU, die die Portierung und Optimierung eines häufig verwendeten großen Vokabular -Continuous -Spracherkennungssystems (LVCSR) unterstützt, kann die Entwicklung vereinfachen.
Weckphrasenerkennung
Mit dieser erweiterten Funktion können Benutzer das System freihändig einschalten, indem das Gerät mit ihrer Stimme aktiviert wird.
Effizienter Multicast zu einem oder mehreren Lautsprechern
Multicasting ist eine Netzwerkadressmethode, mit der Nachrichten gleichzeitig mit der effizientesten Strategie an eine Gruppe von Zielen gesendet werden. Nachrichten werden nur einmal über jeden Link im Netzwerk übermittelt, und Kopien werden nur erstellt, wenn der nächste Link zu mehreren Zielen spaltet, normalerweise bei Netzwerkschaltern und Routern. Wie das User Datagram Protocol (UDP) garantiert Multicast jedoch nicht die Zustellung des Nachrichtenstroms, was zu einer Verurteilung von Nachrichten oder einer nicht organisierten Nachrichtenzustellung führen kann. Zuverlässiges Multicast (RMC) bietet Bestätigungen für Multicast -Pakete (nur Pakete), damit bestimmte bestimmte Multicast -Pakete zuverlässig geliefert werden können. Der Sender wählt den Empfänger mit dem schwächsten RSSI aus, um den Rahmen anzuerkennen. In einer IoT-Umgebung bedeutet die Implementierung von RMC, dass der Wi-Fi-Sender einen der vielen Wi-Fi-Empfänger für die Anerkennung des Rahmensempfangs wählt. Der Sender wählt den Empfänger mit dem schwächsten RSSI aus, um den Rahmen anzuerkennen. Die Implementierung verwendet einen operativen Rahmen, der proprietäre RMC -Informationselemente enthält, um die Anerkennung zu benachrichtigen und zu aktivieren. Die Implementierung enthält auch RMC-spezifische Wi-Fi-Treiberbefehle, um die Multicast-MAC-Adresse festzulegen und die RMC zu aktivieren und zu deaktivieren.
Für Audio und Video mit festen und symmetrischen Übertragungsverzögerungen werden Zeitsynchronisierungsanforderungen erfüllt. Beispielsweise kann sich RMC auf eine hoch genaue Timing und Synchronisation für die Übertragung von Sprach-, Video- und Mobildaten mit Zellen-Zell-Zell-zu-Zellen verlassen. Aus technischer Sicht ist das Erreichen von hoch genauem und präzisen Timing nicht einfach. Daher ist es wichtig, Implementierungen zu finden, die überprüft werden können, um die Anwendungsanforderungen zu erfüllen.
Rahmenformate, Vorwärtsfehlerkorrektur und Paketreplikation
Für das Audio-Streaming ist es wichtig, dass die Uhr mit allen Wi-Fi-Empfängern synchronisiert ist. Ein Ansatz besteht darin, eine gemeinsame Uhr für Quell- und Empfängergeräte zu verwenden, die häufig als Wanduhr oder Systemuhr (STC) bezeichnet wird. Zunächst synchronisiert jeder Empfänger (Empfänger) seine STC (Wanduhr) mit der STC (Master -Wanduhr) des Quelle/Senders. Jeder Empfänger kann jetzt die Uhr des Senders wiederherstellen, da der von der Quelle eingefügte Zeitstempel (im erweiterten Kopfzeilen jedes RTP -Pakets erhältlich) den abgetasteten Moment des Mediens in Bezug auf die gemeinsame Uhr widerspiegelt.
Der STC basiert auf den in der 802.1As -Spezifikation beschriebenen Großmeister -Taktwerten. Da alle Empfängergeräte der Korrelation zwischen dem STC und der Medienuhr des Quellgeräts (wie sich auf den RTP- oder Medien -Zeitstempel bezieht) kennen, kann jeder Empfänger eine Kopie der RTP -Medienuhr des Quellgeräts rekonstruieren und seine Ausgabe entsprechend für die ordnungsgemäße Renderung anstellen. Durch transparentes Handeln können die Hardware/Ucode -Zeitstempelpakete so nah wie möglich an die Mac/Phy -Schnittstelle übertragen werden. Obwohl dieser Taktwert nicht für die Wiedergabe verwendet wird, kann er verwendet werden, um Jitter im gesamten System zu messen und eine vollständige Leistungsanalyse durchzuführen.
Beispiel eines Smart -Home -Audiosystems
Um das IoT -Audio im Kontext zu verstehen, berücksichtigen Sie das Smart -Home -Beispiel und die Rolle, die Audio bei der Verbesserung der Gesamtfunktionalität eines Smart -Home -Systems spielen kann. Ein Haus wird zu einem intelligenten Zuhause, wenn die Geräte und Geräte darin miteinander und den Menschen, die dort leben, kommunizieren können. Durch die Erhöhung unserer Interkonnektivität verbessert Smart Homes unsere Lebensqualität und erhöht unsere Sicherheit.
Einer der Hauptanwendungsfälle für Audio im Smart Home ist das Speichern und Austausch von Audio über Wi-Fi oder Bluetooth. Die Auswahl von Wi-Fi über BLE hängt von der Anwendung ab und hängt von den Anforderungen der Bereiche und der Audioqualität ab. Zum Beispiel kann ein Home Controller in jedem Raum des Hauses ein bestimmtes Geräusch spielen, wenn jemand die Türklingel an der Tür klingelt, anstatt nur die Glocke in einem Teil des Hauses einzubinden. In ähnlicher Weise kann der Controller den Klang auf bestimmte Räume beschränken, z. B. nicht in einem Kindergarten für Babys. Eingebettete Controller helfen dabei, dieses Audio zu verarbeiten und das System durch die Verwaltung verschiedener Ausgabesteuerungsfunktionen intelligenter zu gestalten.
Wiedergabe -Audiosysteme
Wiederholungs -Audiosysteme sind zu einer wichtigen Anwendung auf dem Audiomarkt geworden. Wireless Audio -Wiederholungssysteme stehen im Mittelpunkt des Smart Home, bringen viele verschiedene intelligente Geräte im Haushalt zusammen und treffen intelligente Entscheidungen im Namen des Benutzers. Beispielsweise kann ein Audiosystem die Beleuchtungsmuster in einem Haus steuern, das auf der derzeit abgespielten Musik basiert. Es kann auch eine Text-zu-Sprache-Konvertierung verwenden, um Benutzerbenachrichtigungen oder E-Mails laut zu lesen. Benutzer haben auch die Möglichkeit, Zonen in einem Multi-Room-Audiosystem zu erstellen, indem sie vernetzte Audiogeräte verwenden, z. B. drahtlose Lautsprecher in verschiedenen Räumen des Hauses. Dieser Ansatz schafft ein ganzes Ökosystem, um sicherzustellen, dass das Haus immer mit Spitzeneffizienz arbeitet und gleichzeitig die Interaktionen mit den dort lebenden Menschen minimiert. Um ein solches Ökosystem zu erstellen, müssen IoT-Designer einen eingebetteten Mikrocontroller mit den richtigen Leistung und audiobasierten Funktionen auswählen, die für IoT-Anwendungen optimiert wurden.
Digitale Signalverarbeitungseffekte
Die Verarbeitung von Audiosignalen in der digitalen Domäne ist ein wichtiger Bestandteil eines jeden Audiosystems, bevor Audiodaten über einen drahtlosen Link übertragen werden. Diese Verarbeitung umfasst typischerweise das Messen, Filtern und/oder Komprimieren des Audio -Analogsignals. Eingebetteter MCUs mit integrierter DSP -Funktionalität ermöglichen Effekte wie das Hinzufügen eines digitalen Mixers und die Unterstützung der Fernbedienungsfunktionen. Mit einem 5- -Band -Equalizer für jeden Kanal kann die Audio -Wiedergabe geschickt in die meisten Sequenzeranwendungen integriert werden, um ein leistungsstarkes Studio -System zu erstellen.